# 给女儿做了个作业打印助手,顺便榨了榨小鸡
Source: https://blog.ferstar.org/posts/homework-print-prep/
女儿上了小学,三天两头就有作业资料发到群里,打印作业成了家里的日常。
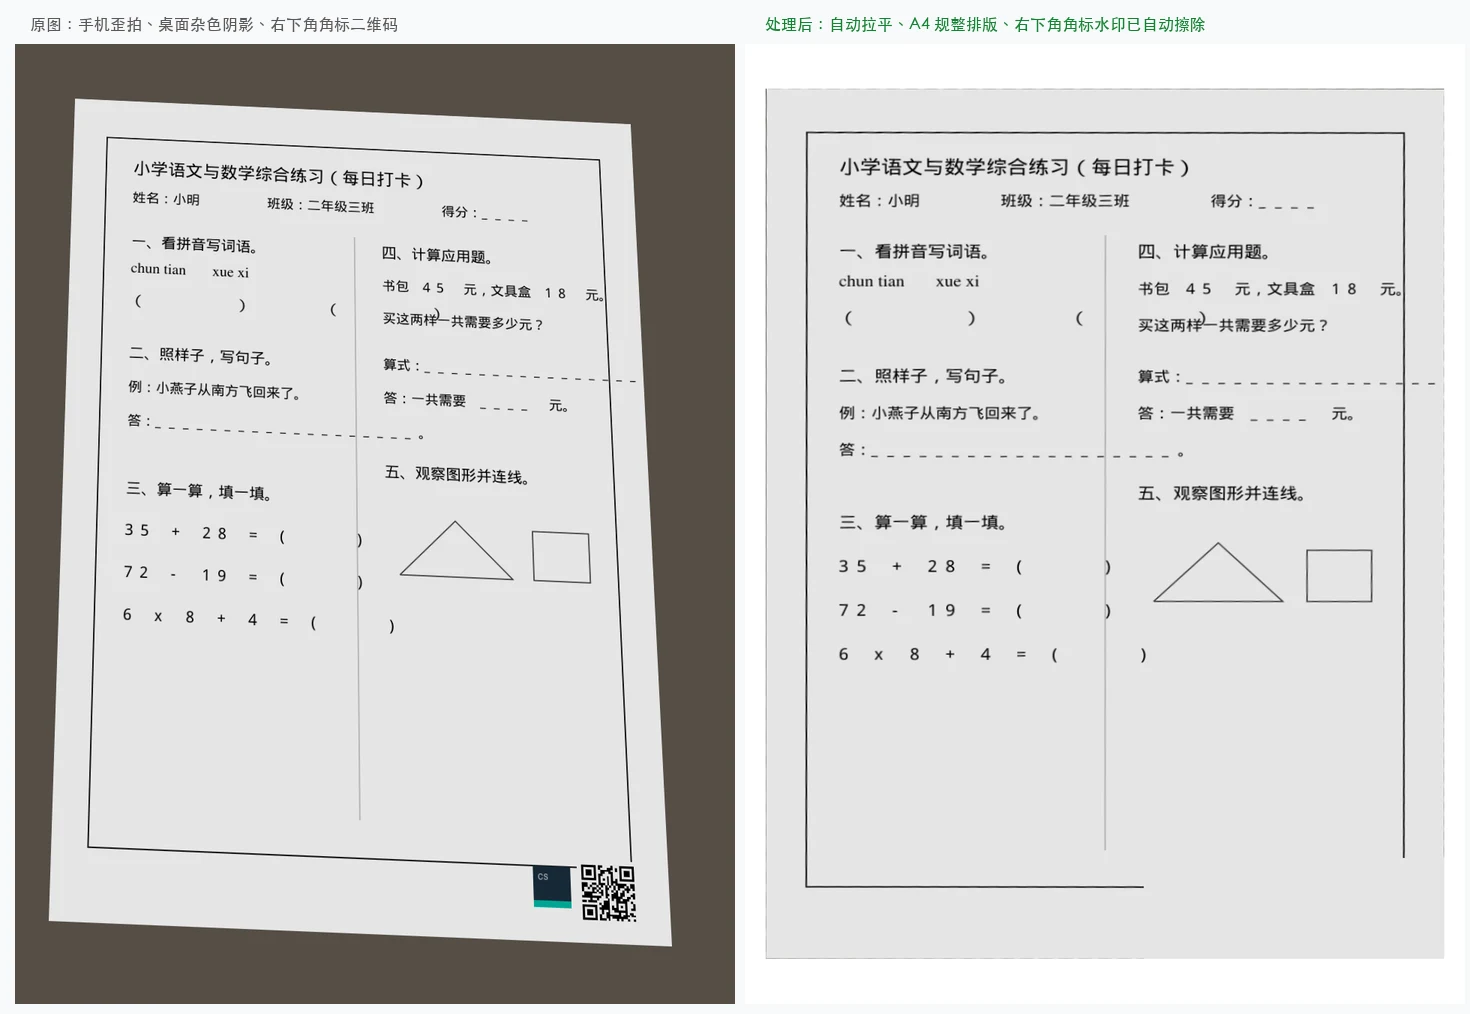
资料的质量有时实在堪忧。PDF、截图、手机照片混着来,纸拍歪了,横的竖的夹在一起,旁边还带着各种水印。直接打印字小费眼,留白倒占了大半;想整理一下,又得裁边、转方向、擦水印。作业还没开始做,老父亲先当起了修图工。
这也不怪老师。你不能要求人家发个作业,还特意买个扫描软件会员去水印,也没人给报销。
既然最后都是我来打印,那就自己解决。
## 从拍照到 A4 打印
于是有了[作业打印助手](https://dazuoye.ferstar.org)。把 PDF 或照片扔进去,自动拉平、清掉杂物、摆正,再排到 A4 纸上。看一眼预览,没问题就下载打印;自动处理不准,也能手动拖四个角、转方向、圈掉多余内容。
要求不高:别让我每次打印都手动折腾一遍就行。
```mermaid
flowchart LR
A["PDF / 照片"] --> B["透视拉平
抠出纸面"]
B --> C["擦除角标
水印清理"]
C --> D["OCR 摆正
四向打分"]
D --> E["裁切排版
铺满 A4"]
E --> F["全文方向统一"]
F --> G["打印预览 / 下载"]
```
## 榨干 2 核小机器
本机跑得还行,放到垃圾小鸡上,速度就下来了。一份作业好几页,每页都要找边界、去角标、判断方向,再做打印排版,叠起来就是一段不太愉快的等待。
我也想过偷懒:要不要把计算扔到 Cloudflare 的容器服务上去?页处理本身是纯函数,看起来挺适合弹性容器。但拉了分支一算账就劝退了:scale-to-zero 唤醒要等十几秒冷启动,家长打印作业等不起;要是为了免冷启动让它常驻,内存费每个月得好几十刀。给女儿打印作业把免费小鸡换成付费账单,方向属实反了。
既然算力有限,那就老老实实做减法。翻了翻耗时,问题并不全在 OCR。图像处理里一些不起眼的步骤,也在一遍遍扫整张大图;还有些计算,前面已经做过,后面换个环节又做了一次。
```mermaid
flowchart TD
subgraph G1["图像检测金字塔"]
A1["1/4 缩略图快速预检"] -->|干净页面| A2["直接跳过后续角标检测"]
A1 -->|发现杂物| A3["1/2 降采样定位连通域"]
A3 --> A4["映射回原图局部擦除"]
end
subgraph G2["倾角与文字特征复用"]
B1["墨迹掩码只算一次"] --> B2["细分角度只旋转掩码打分
不再反复提取"]
end
subgraph G3["OCR 换小模型、降精度"]
C1["完整文字识别模型"] -.->|只判方向,用不着| C2["PP-OCRv6 tiny
内嵌 Rust worker"]
C2 --> C3["MNN 低精度模式
ARMv8.2+ 走 fp16 内核"]
C3 --> C4["重标 180°/90° 翻转置信门槛
防倒字乱码抢高分"]
end
```
### 先把两个核都用上
小鸡有两个 vCPU,OCR 原来单线程跑,一个核跑满 100%,另一个在旁边看热闹。把线程数和文字区域的并行识别调到适合机器的配置。不过小机器上线程不是越多越好,抢资源反而变慢,设成 2 刚好。
### 少扫几遍大图
找边上的小广告,没必要拿原图每个像素都算一遍;干净页面,也不必完整跑完角标检测。先用 1/4 尺寸的小图做一次便宜的灰度预检,没东西就直接跳过;有杂物再降采样定位,最后把坐标映射回原图擦除。找内容边界也是一样,先降采样拿粗框,没必要反复折腾高分辨率大图。
为了在正负几度内试出最佳角度,原来每次旋转都重新提取一次文字区域。把这份墨迹掩码在基准尺寸上先算好,后面几十个细分角度只做简单的矩阵旋转打分,把重复提取的开销省掉了。
### 模型换小,判据重标
这里 OCR 主要是为了判断文字朝向,没必要按完整的文字录入任务来选模型。换成了轻量的 PP-OCRv6 tiny,内嵌在 Rust worker 里由 MNN 跑。MNN 再开低精度模式(`OCR_PRECISION=low`),ARMv8.2 以上的 CPU 会走 fp16 内核,这台 ARM 小鸡正好支持。模型换小、精度降下来,置信度的分布也跟着变了,正反向的判据得重新标定,尤其要把门槛拉高:倒着的文字认成一堆乱码,分数反而更高,这种事不能发生。
### 干过的活别再干
整份作业如果多数票已经定好了横版或竖版,就不给每页重复跑整套 OCR;导出时已有能用的页面图,就直接嵌入,不重新走一遍解码转换。每页处理完保留一份无损缓存,调边距、去局部的操作直接复用中间图,别让人改个设置又从头等一遍。
算力抠出来了,还得防被打崩。2 核的机器,几个大 PDF 一起灌进来就够它受的。所以在服务入口加了个严格 FIFO 的准入队列:同时最多跑 2 个任务,最多排 4 个,满了直接返回 429,告诉前端 15 秒后再试;排队太久的也会超时退出,不让请求一直挂着。
页面上点赞点踩的反馈,顺手落到了本地 SQLite。没表态的页面 1 天就清理,点踩的留 30 天,正好攒成回测算法用的样本。
这样一点点抠下来,垃圾小鸡上普通页面基本能压到三四秒一页——刚上线那会儿,同样一页要十几秒。当然,遇到特别复杂的拍照图耗时会更长一些。
没升配,只是看清时间花在哪,哪些活可以少做,哪些根本不该重复做。
## 守住题目的完整性
打印作业这件事,速度排在题目完整后面。水印没擦干净还能凑合;把拼音声调、算式里的细线或者页角的题目一起擦了,就属于帮倒忙。
所以每轮优化还得看前后对比,检查旋转、透视、阴影、浅色细笔画这些情况。小图检测省下的时间,不能拿丢内容来换。自动判断拿不准,就保留原图,让我手动改。
纸白增强也默认关了。纸面提亮是好看些,但要是把题目里的细线、浅色印刷或者拼音声调给冲淡了,好看有什么用。真遇到灰纸、阴影明显的照片,再打开看看效果。
四角调整同样得听人的:我都手动框好纸张了,后面就别再自作聪明裁一遍。工具应该少给我添活。
现在打印前扫一眼预览就行,不用再一份份手工收拾。女儿负责做作业,老父亲负责让那几张纸看着舒服点。至于小鸡,顺手榨了榨,图个乐子。